

Cât costă în realitate să pui AI în producție?
Plecăm de la o limită explicită: 50.000 euro pentru construcție și următorii doi ani de operare. 2 ani de TCO înseamnă implementarea inițială plus doi ani de operare integrată în companie, dar fără costurile de pe partea clientului. Se includ dezvoltarea software, integrarea de date, factura pentru model (ex: Gemini), costurile cloud, monitorizarea și mentenanța.
Răspunsul pe scurt: 50.000 euro sunt suficienți pentru proiecte AI bine delimitate. Dar diferența dintre 1.000 și 100.000 de execuții de agent pe lună poate schimba complet costul. Discutăm la final cum puteți administra succesul, dacă ajungeți la scalare spectaculoasă.
1. Ce aplicație AI poți construi sub 50.000 euro
Dăm câteva tipologii de proiecte realiste, cu observația că aceste sume sunt estimări de piață pentru proiecte de complexitate mică și medie și nu constituie o ofertă.
| Proiect | TCO - 2 ani (Estimare complexitate mică-medie) |
|---|---|
| AI pentru documente și knowledge search în documentele companiei | 15.000-30.000 euro |
| Analiză conversații telefonice de vânzări și suport, inclusiv live | 20.000-40.000 euro |
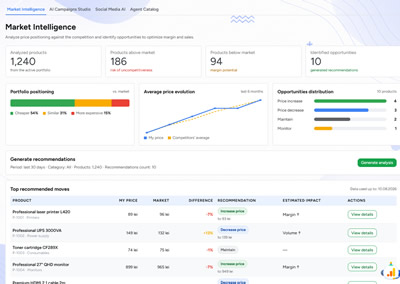
| Price & Stock Intelligence pentru comparare și poziționare pe piață | 25.000-45.000 euro |
| Raportare conversațională peste ERP/CRM pentru investigarea datelor proprii fără rapoarte predefinite în BI | 25.000-45.000 euro |
| Agenți AI peste ERP pentru vânzări, aprovizionare sau pricing | 30.000-50.000 euro |
2. Formula de calcul: Setup o dată + Run 2 ani
În Capitolul 5 al Ghidului de vânzări AI în B2B 2026 am separat bugetul AI în două părți:
Setup = arhitectură, dezvoltare software, integrarea și curățarea datelor, reguli de business, testare și lansare.
Run = cloud, AI, monitorizare, mentenanță, suport și ajustări.
Pentru proiectele analizate în ghid, estimarea orientativă pentru etapa Run (Rulare) este de aprox. 5-15% din costul Setup (Setare)/an pentru cloud, 15-25% pentru mentenanță și suport și 0-15% pentru curățarea continuă a datelor.
Intervaluri de preț rezultate:
| Setup inițial | TCO orientativ 2 ani* |
|---|---|
| 15.000 EUR | 21.000-31.500 euro |
| 20.000 EUR | 28.000-42.000 euro |
| 25.000 EUR | 35.000-52.500 euro |
| 30.000 EUR | 42.000-63.000 euro |
Notă: TCO orientativ nu include costurile suplimentare pe partea clientului, de exemplu infrastructura on-prem sau costul muncii angajaților proprii. Calcul este bazat pe metodologia Setup/Run din Ghidul #1 și nu constituie o ofertă (Ghid #1)
Pentru a se plasa în primele rânduri ale tabelului (TCO sub 50.000 euro), proiectul trebuie să aibă un obiectiv clar, puține integrări și un volum controlabil.
Studii de caz
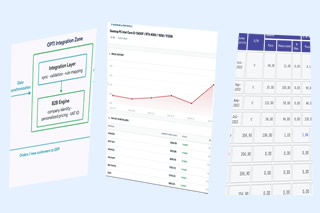
Într-un proiect OPTI pentru un distribuitor cu peste 20.000 SKU, integrarea AI cu Entersoft ERP a redus timpul mediu de ofertare de la 23 la 7 minute.
Vezi studiul de caz AI + ERP Entersoft
Într-un proiect de monitorizare de prețuri, o aplicație construită cu BigQuery și Gemini urmărea după două luni aproximativ 2.000 de produse din 20 de surse.
3. Cât costă să rulezi agenți AI peste sisteme ca ERP?
Companiile doresc să implementeze AI pentru eficientizarea operațiunilor derulate în software-uri clasice, ca ERP, CRM, WMS. Dar o confuzie frecventă spune că tot costul ar fi de tokeni. Din experiență, costul agentului AI nu este costul tokenilor.
O arhitectură enterprise tipică de AI implică stadiile de mai jos, fiecare cu costurile lor:
1. ERP / CRM / WMS 2. Strat de date 3. Agent: unelte și acțiuni 4. Agent: model AI 5. Agent: observabilitate 6. Controlul acțiunilor / Human-in-the-Loop.
Pe scurt, aplicațiile existente trebuie să trimită datele unificate, de-abia la acel nivel poate rula agentul AI, care nu este doar modelul, ci necesită unelte și trebuie să fie măsurat și supravegheat, inclusiv printr-un strat final unde poate apărea aprobarea umană.
Straturile au moduri diferite de calcul al costului, cum am documentat în august 2026:
| Strat | Detalii | Cum scalează |
|---|---|---|
| ERP + Strat de date | Integrare, sincronizare, curățare de date | predominant stabil: Setup + mentenanță |
| Agent harness | Orchestrare, runtime, sesiuni, memorie | Run variabil cu volumul: per execuții / runtime / stocare |
| Unelte | Grounding (search), OCR, API-uri, email etc. | Run variabil cu volumul: per căutare / apel / email |
| Model | Tokeni de input, output, reasoning | Run variabil cu volumul: per token |
| Observabilitate | Loguri, traces, evaluări | Setup și Run variabile cu numărul și complexitatea execuțiilor |
| Controlul acțiunilor / Human-in-the-Loop | Verificarea acțiunilor, loguri și efecte externe | Setup predominant stabil, Run variabil cu volumul: excepții, reguli |
Google Cloud tratează separat modelul AI de serviciile agentice, tokenii modelului fiind facturați separat. Iar diferența de preț dintre modele este mare. La tarifele publice actuale pentru contexte sub 200K:
| Model Vertex AI | Input / 1M tokeni | Output / 1M tokeni |
|---|---|---|
| Gemini 2.5 Flash Lite | $0,10 | $0,40 |
| Gemini 2.5 Flash | $0,30 | $2,50 |
| Gemini 2.5 Pro | $1,25 | $10,00 |
Sursa: Google Cloud, verificat 30 septembrie 2026 (Google Cloud)
De aceea, un agent AI care verifică dacă un client a început să cumpere mai puțin poate folosi un model mai ieftin față de unul care construiește o ofertă complexă.
De ce contează observabilitatea?
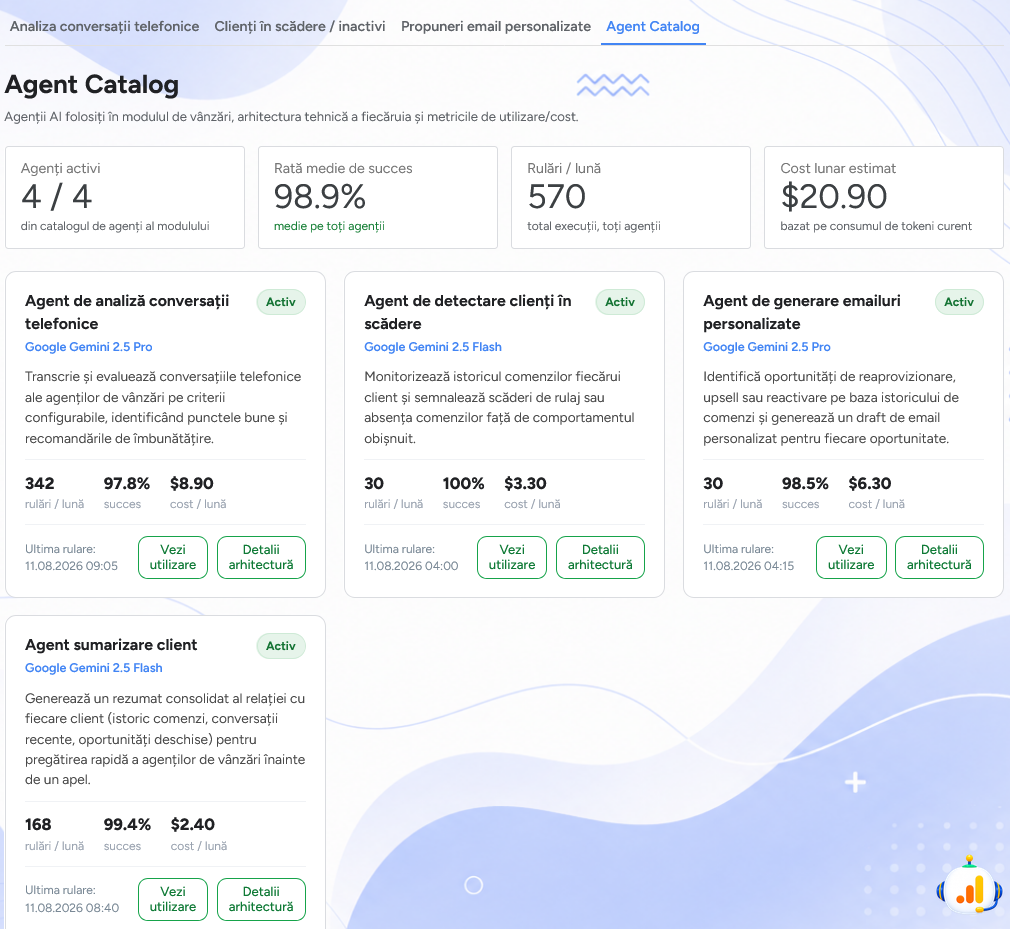
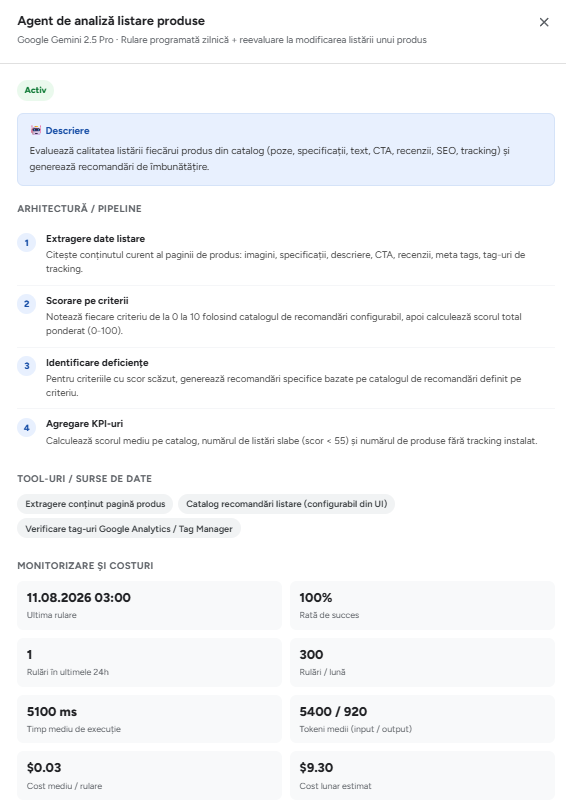
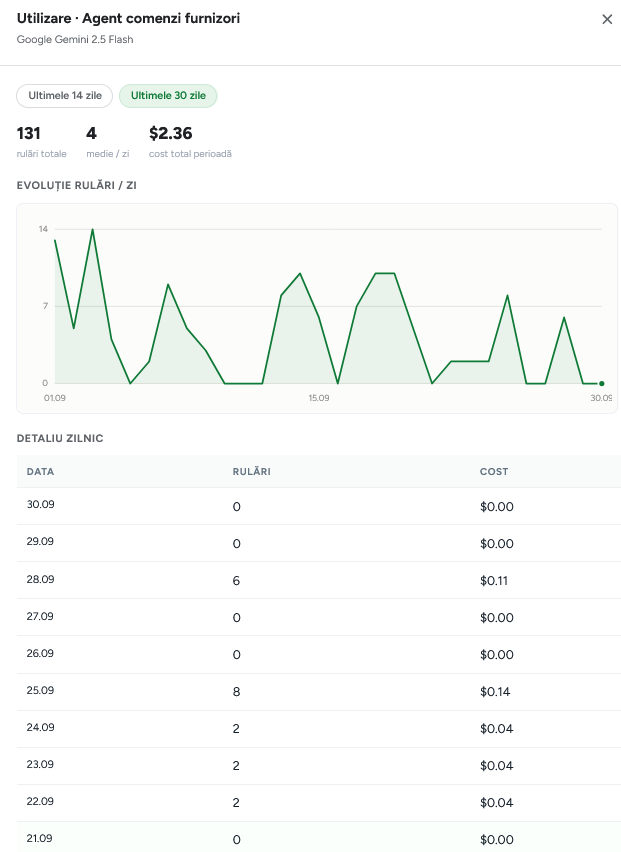
Ca exemplu, în platforma noastră Vânzări cu AI 2.0, monitorizăm și afișăm separat execuțiile, rata de succes, tokenii și costul estimat. Un agent care analizează calitatea unei listări de produs are, într-o execuție tipică din demo:
5.400 tokeni input + 920 tokeni output + alte unelte = aprox. $0,03 / rulare. Pe platforma demo patru agenți monitorizați împreună au afișate 570 rulări/lună, 98,9% rată medie de succes și aproximativ $20,90 cost lunar estimat.
Observabilitatea nu este doar o funcție tehnică. Pentru un flux AI, Google Cloud și analiza OPTI detaliată recomandă urmărirea costului per sarcină reușită, nu costul per token: un agent ieftin care eșuează frecvent poate fi mai scump per rezultat util.
4. De la 1.000 la 100.000 de rulări pe lună
Să păstrăm exemplul de mai sus cu $0,03 / agent run. Presupunem aceeași complexitate a execuției și același cost unitar:
| Agent runs / lună | Cost modele / lună | Cost modele / 24 luni |
|---|---|---|
| 1.000 | $30 | $720 |
| 10.000 | $300 | $7.200 |
| 100.000 | $3.000 | $72.000 |
Acesta este numai consumul AI estimat, nu costul complet al aplicației. La 1.000 de rulări pe lună, tokenii sunt foarte puțin relevanți față de integrare și dezvoltare. La 10.000, sunt o mini-linie bugetară. La 100.000, depășesc singuri plafonul din articol.
Articolul nostru anterior despre costurile AI în 2026 avertiza că prețul modelului poate scădea în timp ce factura totală a aplicației crește: aplicațiile agentice fac mai multe apeluri, folosesc mai multe servicii și ajung să fie executate mai des.
Gartner estimează că un task agentic poate folosi de 5 până la 30 de ori mai mulți tokeni decât o interacțiune standard cu un chatbot. (Gartner)
În concluzie, prima întrebare pentru bugetare e aceeași ca în dezvoltarea software: Ce proces vrem să automatizăm, de câte ori va rula și cât valorează o execuție reușită?
5. Cum evit creșterea liniară a costurilor în caz de succes?
La finalul articolului, iată patru recomandări simple pentru a administra creșterea liniară a costurilor cu volumul în caz de succes.
Automatizare înainte de AI. Dacă o regulă/trigger în baza de date (ex: SQL) sau un flux determinist clasic rezolvă problema, nu apela la modele AI.
Model routing. Folosește modele ieftine (Ex: Flash/Lite) pentru sarcini repetitive, modele mai scumpe doar când complexitatea o justifică. Routing-ul poate fi implementat în aplicație, dar Google oferă și Model Optimizer pentru selectarea automată a nivelului de model în funcție de cost și calitate.
Context mai mic și cache de reutilizare. Nu retrimite la fiecare rulare mii de rânduri din ERP (Ex: tot istoricul clientului). Extrage cu atenție numai contextul necesar, cache-uiește unde este posibil și evită apelurile duplicate. Există deja servicii automate de caching context la apelare modele AI, de exemplu Google activează implicit caching.
Măsoară costul pe rezultat, nu doar pe token. Ca să poți vedea factorii de creștere liniară, monitorizează ca în exemplele de mai sus rulările, rata de succes, cost/rulare și cost/successful task. Ele trebuie să fie observabile din aplicație, de aceea am inclus observabilitatea externă ca strat obligatoriu.
Perspective: aceeași performanță AI devine mai ieftină
Un studiu Epoch AI publicat pe 22 sept. 2026 estimează că, din 2023, costul pentru același nivel de performanță AI a scăzut în medie cu aproximativ 47% pe trimestru, de 13X / an. Dacă direcția istorică continuă, costul variabil bine monitorizat poate scădea (Epoch AI).
Separat, Gartner estimează că până în 2030 costul de inferență suportat de furnizori pentru un LLM de 1 trilion de parametri va fi cu peste 90% mai mic decât în 2025. Gartner avertizează totuși că agenții AI tind să consume cât mai mult și sunt folosiți mai des, astfel încât factura totală poate totuși crește. (Gartner)
În concluzie, poți construi un proiect real cu TCO pe 2 ani sub 50.000 euro. El va putea analiza documente sau conversații, urmări piața, interoga datele ERP ori executa un proces comercial prin agenți AI. La volume mici, integrarea și software-ul costă mult mai mult decât tokenii. La volume mari, costul per agent run devine critic, ceea ce necesită monitorizare continuă.
Ai un proiect AI de dimensionat? Răspunde la 5 întrebări:
- Ce proces vrem să automatizăm?
- Cu câte sisteme trebuie integrat?
- Câte execuții estimăm pe lună?
- Ce se întâmplă dacă agentul AI greșește?
- Ce valoare economică are o execuție reușită?
OPTI proiectează și implementează aplicații AI integrate cu ERP, CRM și datele companiei. Lucrăm cu clienți din România și din piețe internaționale.
Resurse:
Ghid OPTI #1, Cap. 5 - Costuri și guvernanță AI: Setup vs Run
OPTI - Costurile AI în prima jumătate din 2026
OPTI - Agenți AI peste ERP on-prem
OPTI - Studiu de caz: Upgrade AI pentru vânzări din Entersoft
Google Cloud - Prețuri Gemini / Agent Platform
Epoch AI - The Plunging Price of Thought, 22.09.2026
Gartner - GenAI inference cost forecast, 25.03.2026